马尔科夫决策过程 是 马尔科夫奖励过程 加上 智能体 的动作得到的
马尔科夫决策过程#
具有 马尔科夫性质 的 随机过程
随机过程#
以我的理解,就是以条件概率描述一种状态,指当前状态受历史影响。
下一个状态取决于 t 时刻之前的状态。我们将已知历史信息 (S1,…,St) 时,下一个时刻状态为 St+1 的概率表示为 P(St+1∣S1,…,St)。
马尔科夫性质#
一个随机过程某时刻的状态 只取决于 上一时刻的状态
P(St+1∣St)=P(St+1∣S1,…,St)再回到马尔科夫过程#
马尔科夫过程也叫做马尔科夫链,可以由元组描述⟨S,P⟩描述。关于转移矩阵,感觉其实有点像有向图,跟那个思想很像,就是把边权重改成状态转移概率了,有关变换如下图
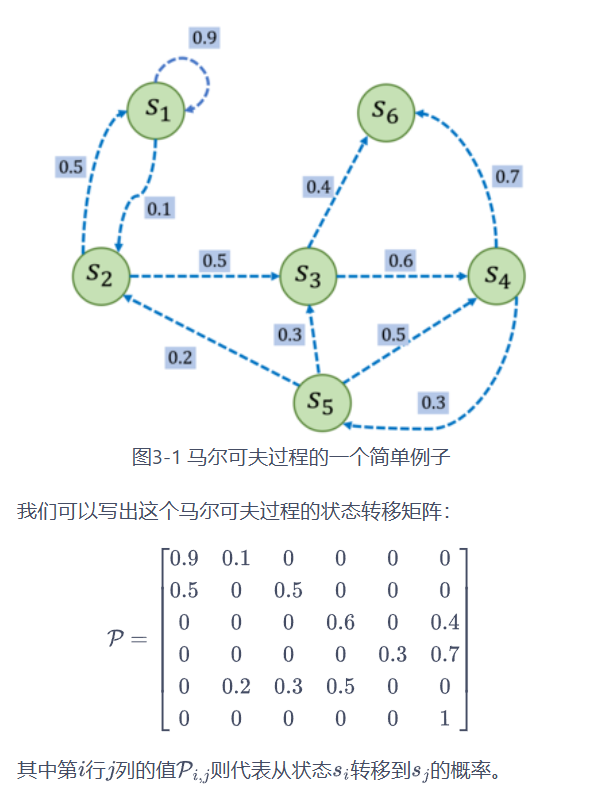 注意啊,状态集合记为 S={s1,s2,…,sn}。它是一个集合,不是指某一个状态。
有了这个过程,我们就可以进行从一个状态变到另一个状态了,从头变到尾就可以生成一个 序列 也叫 采样 。换个名字更熟悉episode/sampling(话说这两个单词在代码里面真的蛮常见的)
马尔科夫奖励过程#
马尔科夫奖励过程可以用元组 ⟨S,P,r,γ⟩ 描述,其中:
- S 是有限状态的集合。
- P 是状态转移矩阵。
- r 是奖励函数,某个状态 s 的奖励 r(s) 指转移到该状态时可以获得奖励的期望。
- γ 是折扣因子(discount factor),γ 的取值范围为 [0,1)。
- 引入折扣因子的理由为远期利益具有一定不确定性,有时我们更希望能够尽快获得一些奖励,所以我们需要对远期利益打一些折扣。接近 1 的 γ 更关注长期的累计奖励,接近 0 的 γ 更考虑短期奖励。
在某一状态时,所有奖励的衰减之和称为回报 Gt(Return),公式如下:
Gt=Rt+γRt+1+γ2Rt+2+⋯=k=0∑∞γkRt+k这个不用纠结,知道是啥就好了,都是人为定义的。不过这个跟后面的状态价值函数有密切联系。还有这个公式本身也是个数列递推式,后面会有很奇特的展开来简化算法复杂度的。
状态价值函数#
有了回报 Gt 之后,就可以定义状态价值函数 V(s)。
我的理解是,状态价值函数就是在某个状态 s 出发时,对未来回报的期待。也就是说,未来可能会采样出很多条不同的轨迹,每条轨迹都有自己的回报 Gt,而 V(s) 关心的是这些回报的期望值。
从这个角度看,V(s) 有点像回报 Gt 的某种统计学参数,更准确地说,它是“在当前状态为 s 的条件下,回报的期望”:
V(s)=E[Gt∣St=s]结合马尔科夫奖励过程,状态价值函数也可以写成下面的递推形式:
V(s)=r(s)+γs′∈S∑p(s′∣s)V(s′)这个公式对写代码很重要。它可以理解成:
- 当前状态 s 的价值,等于当前能获得的奖励 r(s);
- 再加上从当前状态转移到所有可能的下一个状态 s′ 后,那些状态价值的加权平均;
- 权重就是状态转移概率 p(s′∣s);
- 未来价值还要乘上折扣因子 γ。
如果用代码思维来看,V(s) 可以理解成一个表:
马尔科夫决策过程#
简单来说,马尔科夫决策过程(Markov Decision Process,MDP)本质上就是在马尔科夫奖励过程(MRP)的基础上,加上了智能体的动作。
也就是说,MRP 里状态怎么转移、得到什么奖励,基本是环境自己随机决定的;而 MDP 里多了一个智能体,智能体可以在某个状态下选择动作 a,动作会影响后续的状态转移和奖励。
所以马尔科夫决策过程可以用下面这个元组描述:
⟨S,A,P,r,γ⟩其中相比 MRP,多出来的就是动作集合 A:
策略 π:给定状态 s,决定选择哪个动作 a。
π(a∣s)=P(At=a∣St=s)代码里可以理解成:
状态价值函数#
状态价值函数 Vπ(s):状态 s 在策略 π 下的长期价值。
Vπ(s)=Eπ[Gt∣St=s]动作价值函数#
动作价值函数 Qπ(s,a):在状态 s 下执行动作 a 的长期价值。
Qπ(s,a)=Eπ[Gt∣St=s,At=a]贝尔曼方程#
贝尔曼方程:用“当前奖励 + 折扣后的未来价值”更新当前价值。
V(s)=r(s)+γs′∑p(s′∣s)V(s′) 
